Tous secteurs
Aiguillage des pages de documents avant ingestion dans un assistant
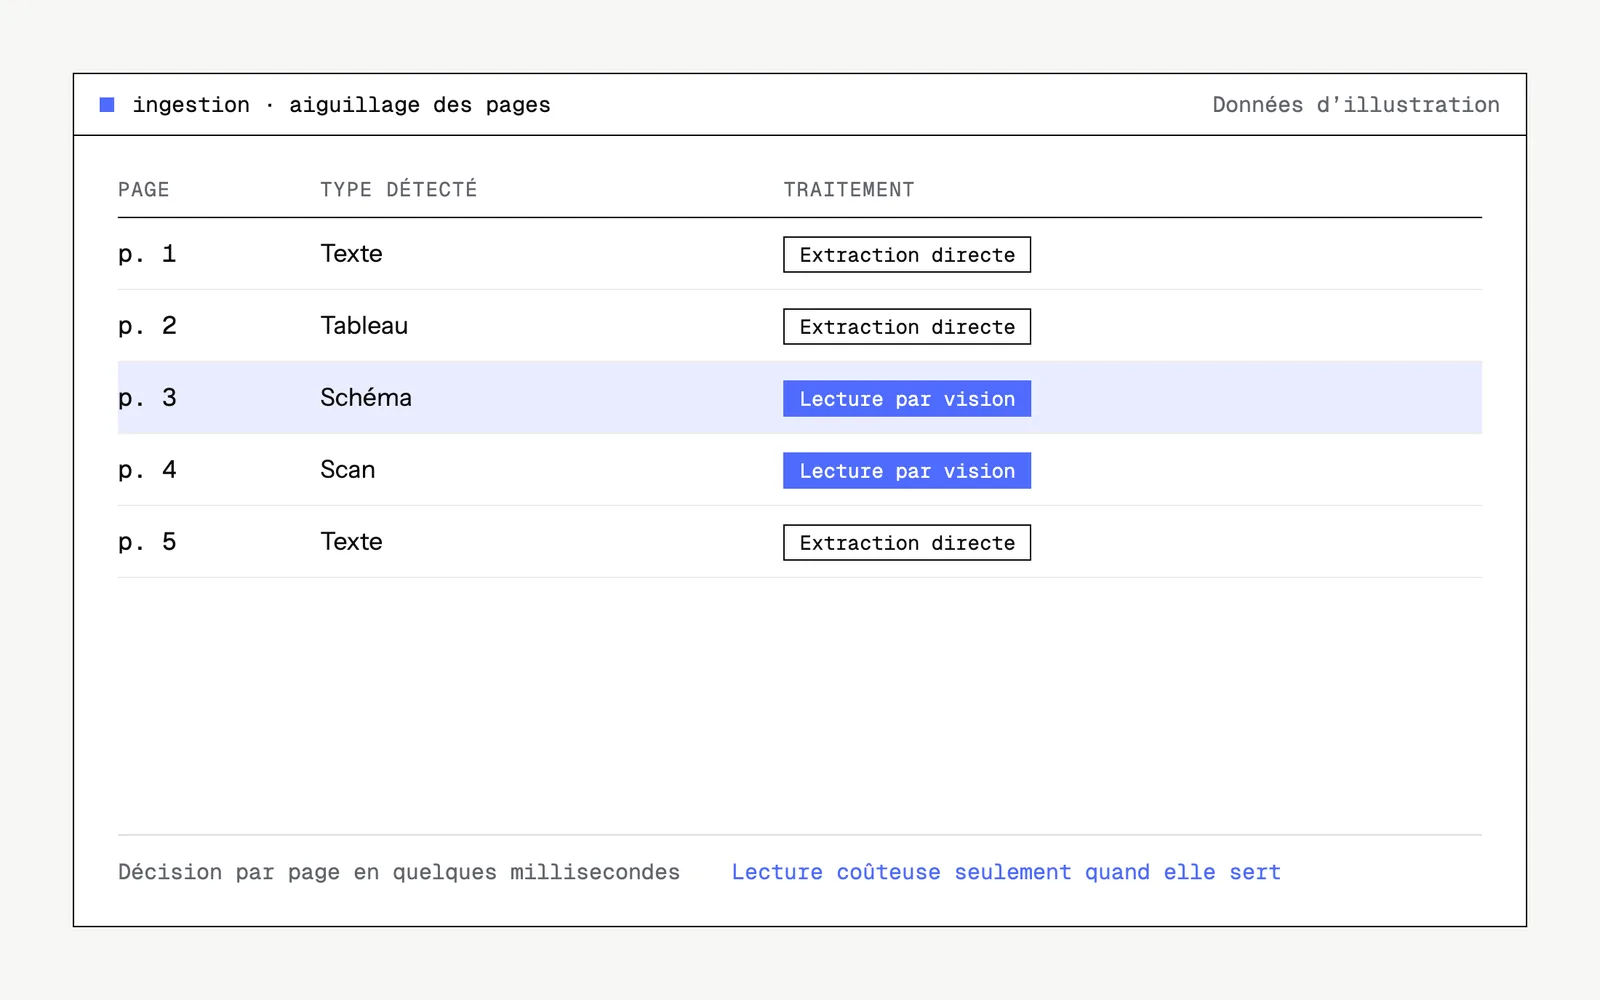
Chaque page d'un document PDF est orientée automatiquement vers l'extraction de texte gratuite ou vers une lecture par modèle de vision, seulement quand c'est utile. Le client ingère plus vite et paie la lecture coûteuse uniquement pour les pages qui en ont besoin.
Contexte
Une organisation alimente son assistant IA avec des documents internes synchronisés chaque jour depuis SharePoint : supports, examens, procédures, chartes.
Le problème
Envoyer toutes les pages à un modèle de vision coûte cher et ralentit l'ingestion ; se contenter de l'extraction native perd les figures, les formules et les pages scannées.
Ce que nous avons construit
Un routeur page par page : un encodeur visuel figé et trois petits classifieurs prédisent si l'extraction native va échouer (image utile, formule, scan), plus deux pré-filtres textuels sans modèle. Il tourne sur le GPU déjà occupé par la chaîne de recherche, sans matériel dédié.
Étapes
- 01Constitution d'un corpus de 20 documents, 999 pages et 1 951 questions de vérification
- 02Entraînement de trois têtes de décision sur un encodeur visuel figé
- 03Mesure du gain à coût égal, validée par un second annotateur et répliquée sur un banc public
- 04Intégration dans la chaîne d'ingestion du client
Hébergement et modèles
Encodeur DINOv3 figé (SigLIP 2 ou DINOv2 possibles, sous licence Apache 2.0), inférence sur un GPU T4 partagé avec l'embedder et le reranker. Modèle de vision appelé pour les pages routées (Qwen3.5-2B et Gemini Flash évalués).
Services mobilisés
L'IA dans vos applications · Forward Deployed Engineers
Nous ne nommons un client qu'avec son accord écrit. Les budgets et les résultats détaillés de nos missions restent confidentiels.