Énergie · Industrie
Assistant de recherche documentaire avec sources citées
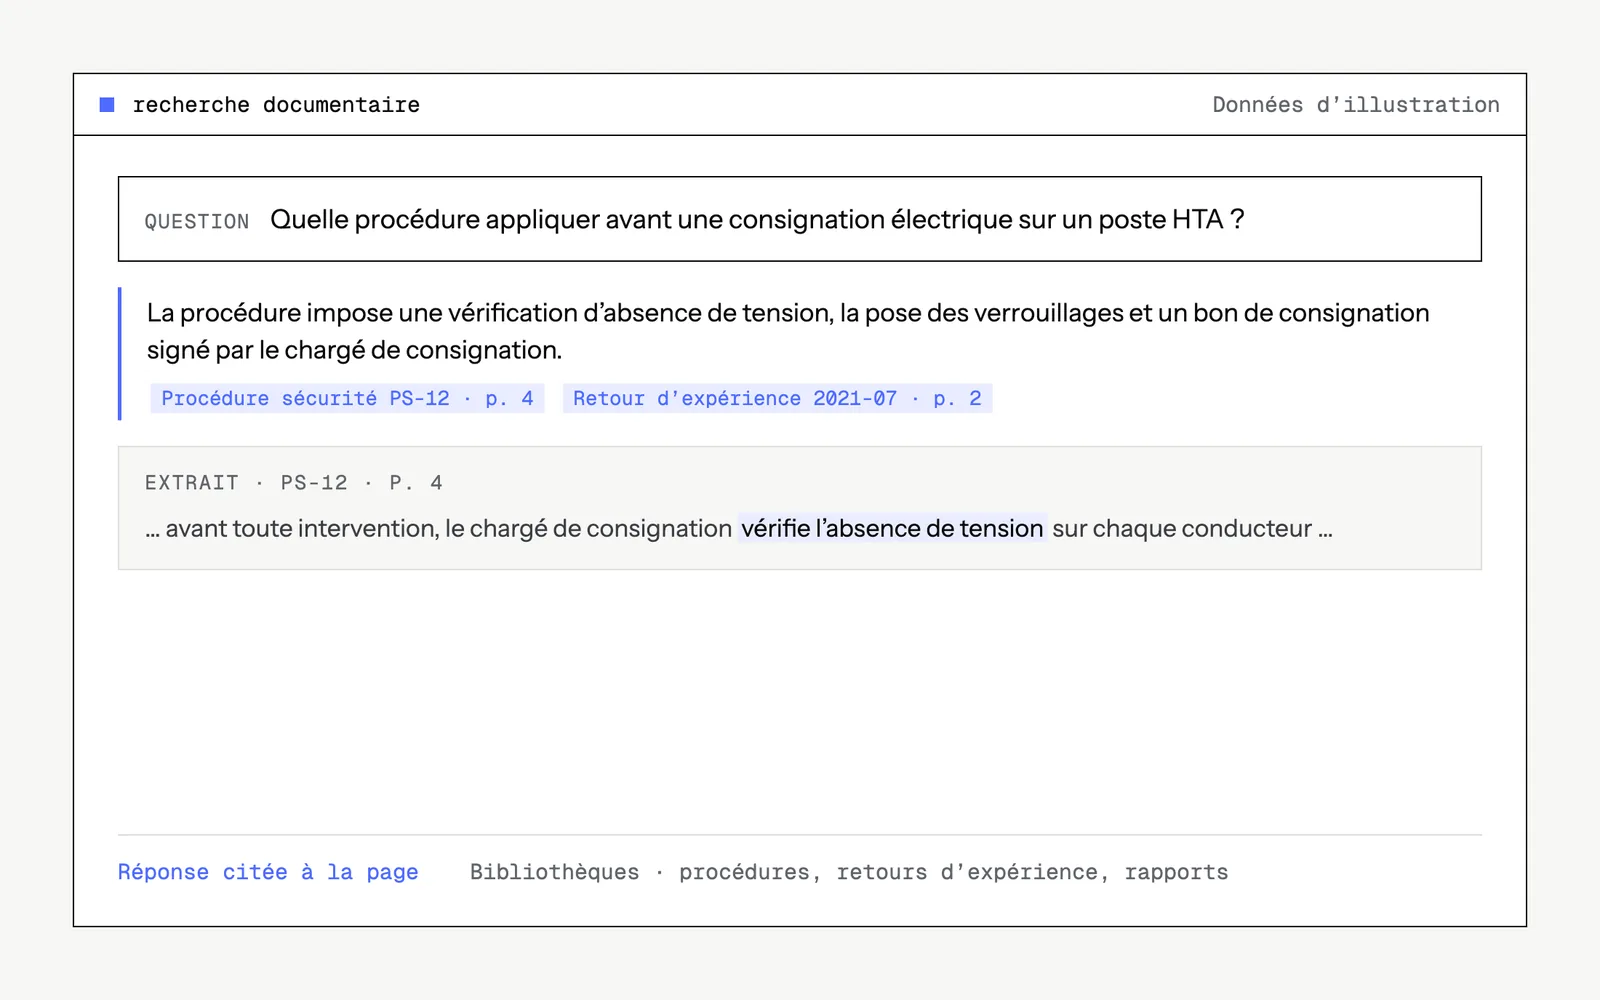
Les équipes interrogent en langage naturel leurs documents techniques, leurs procédures et leurs retours d'expérience, et chaque réponse renvoie au document et à la page d'où elle vient.
Contexte
Un grand groupe de l'énergie accumule depuis des années des documents techniques, des retours d'expérience et des dossiers de projet, rangés dans des bibliothèques qu'on n'interroge pas facilement.
Le problème
Retrouver une information enfouie dans des milliers de documents, parfois de plusieurs centaines de pages et en plusieurs langues, prenait des heures, et les outils génériques ne citaient pas leurs sources.
Ce que nous avons construit
Une plateforme conversationnelle interne : ingestion des documents (OCR, extraction, découpage, vectorisation), recherche hybride avec reclassement, réponses qui citent la page source, espaces personnels et bases de connaissances partagées, recherche web, mémoire utilisateur, authentification par l'annuaire de l'entreprise. La plateforme est aujourd'hui reconstruite sur une architecture plus solide, sans changer ce qu'elle fait pour les utilisateurs.
Étapes
- 01Ingestion et indexation des bibliothèques documentaires (OCR, découpage, vectorisation)
- 02Recherche hybride, reclassement et réponse citée à la page
- 03Déploiement sur le cloud privé du client, connexion à l'annuaire d'entreprise
- 04Retours d'expérience collectés auprès des utilisateurs et support continu
Hébergement et modèles
Cloud privé OVHcloud en France (Kubernetes managé, PostgreSQL, stockage S3, datacenter de Gravelines). Modèle principal Qwen3.5-397B servi par OVHcloud AI Endpoints. La passerelle de la version en production déclare aussi des modèles Claude via AWS Bedrock (régions EU et US).
Services mobilisés
Plateformes agentiques · Forward Deployed Engineers · Formation et maintenance · Stratégie IA et cloud
Nous ne nommons un client qu'avec son accord écrit. Les budgets et les résultats détaillés de nos missions restent confidentiels.