Tous secteurs
Passerelle multi-modèles avec routage par complexité
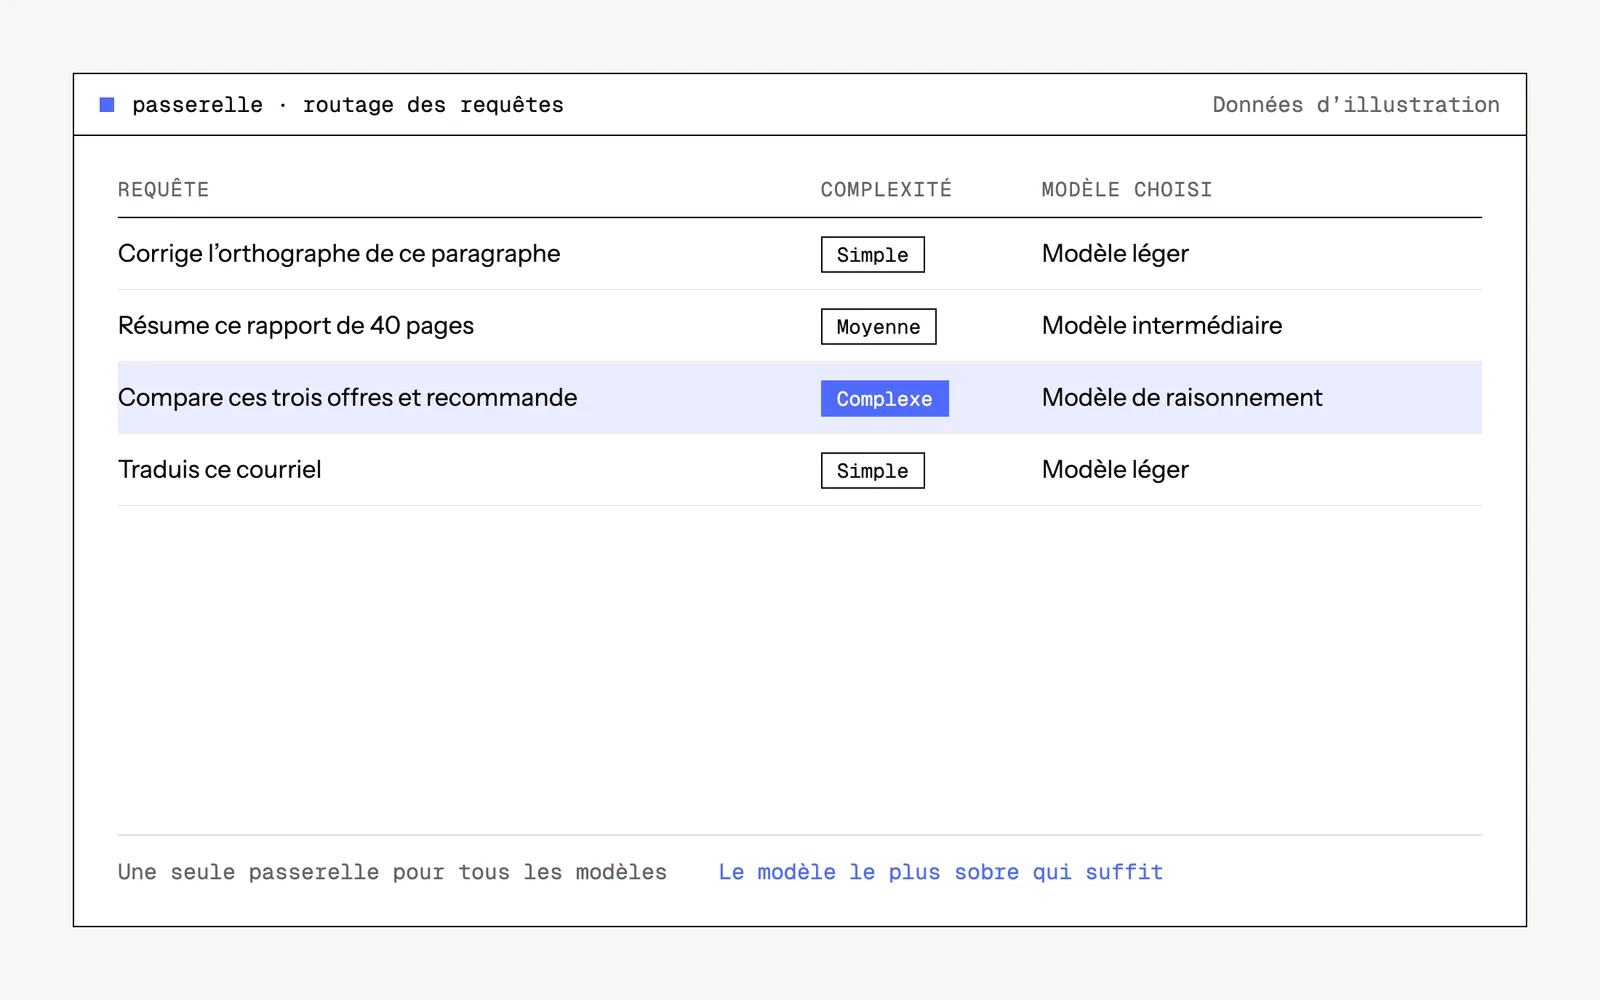
Chaque requête est classée simple, moyenne ou complexe puis envoyée au modèle le plus sobre capable d'y répondre. L'organisation peut changer de modèle sans refaire l'intégration.
Contexte
Organisation qui veut utiliser plusieurs modèles (marché et ouverts) sans multiplier les intégrations ni les coûts.
Le problème
Un modèle haut de gamme pour chaque message coûte cher et ralentit ; un modèle unique crée une dépendance.
Ce que nous avons construit
Proxy LiteLLM unique pour tous les modèles, juge de complexité en amont de chaque requête, variantes de configuration par profil d'utilisateur, bancs de mesure pour choisir les modèles de chaque niveau sur des critères vérifiables par programme.
Étapes
- 01Passerelle unique et clés par application
- 02Juge de complexité à trois niveaux
- 03Bancs de sélection des modèles (justesse, latence, coût)
- 04Choix documenté des modèles par niveau
Hébergement et modèles
Proxy LiteLLM sur le cloud du client ; modèles Gemini et Claude via Vertex AI ; bancs réalisés sur une plateforme d'API de modèles ouverts hébergée en France (Scaleway Generative APIs).
Services mobilisés
Plateformes agentiques · Stratégie IA et cloud
Nous ne nommons un client qu'avec son accord écrit. Les budgets et les résultats détaillés de nos missions restent confidentiels.